A tarefa
Um site de conteúdo vive ou morre pela estrutura. O portal tinha que caber centenas de materiais e continuar navegável: por país, por editoria e por data, com notícias curtas e guias longos no mesmo feed.
A segunda parte é o que a busca enxerga. Os temas foram mapeados antes de alguém escrever qualquer coisa, para que cada página responda a uma busca e as seções se apoiem em vez de disputar as mesmas palavras.
O que construímos
O portal inteiro em uma tela
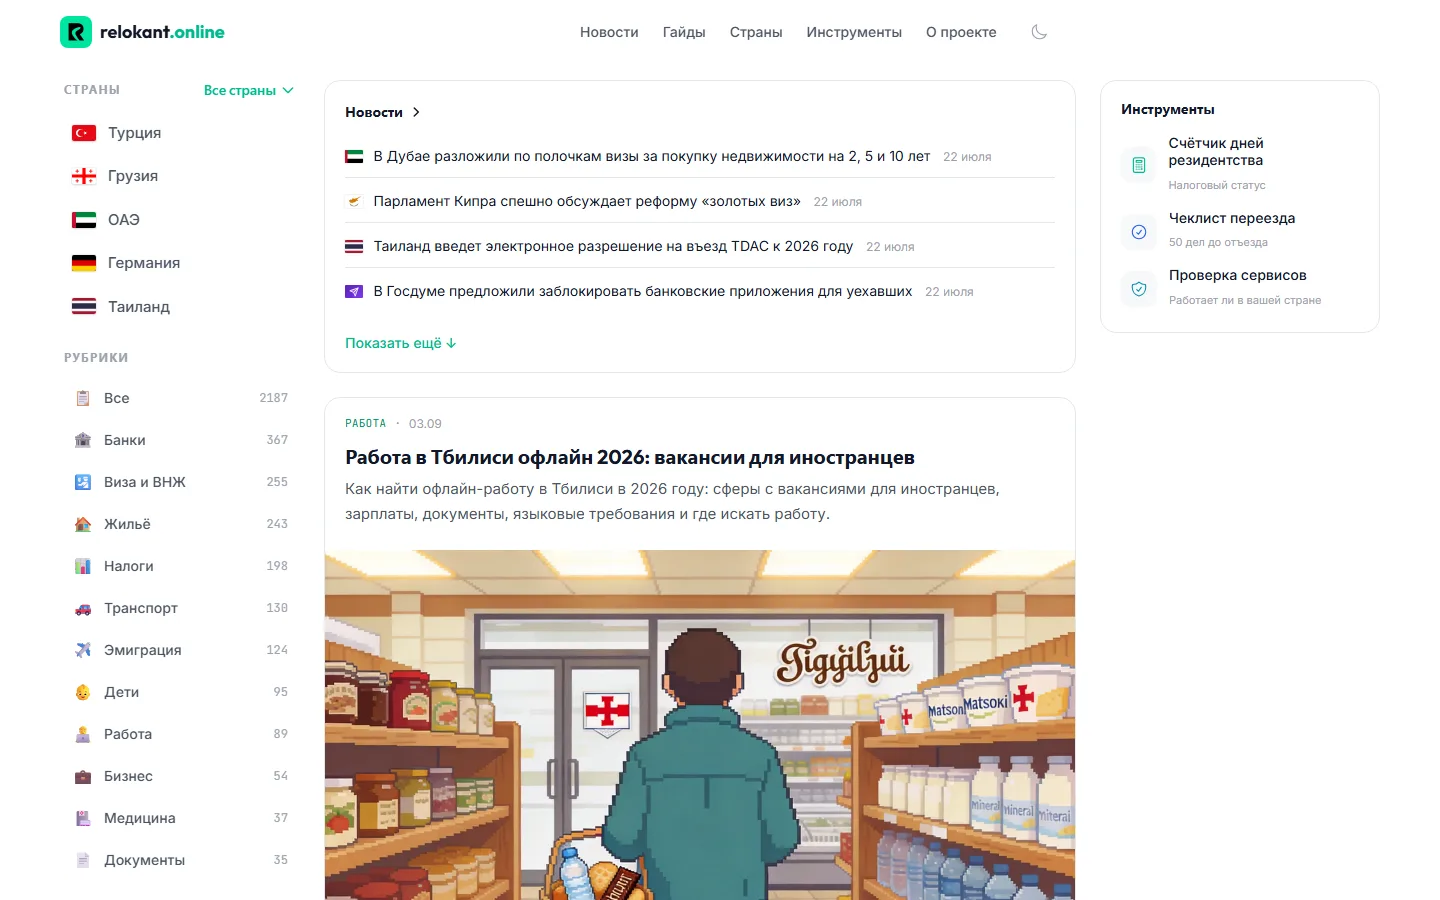
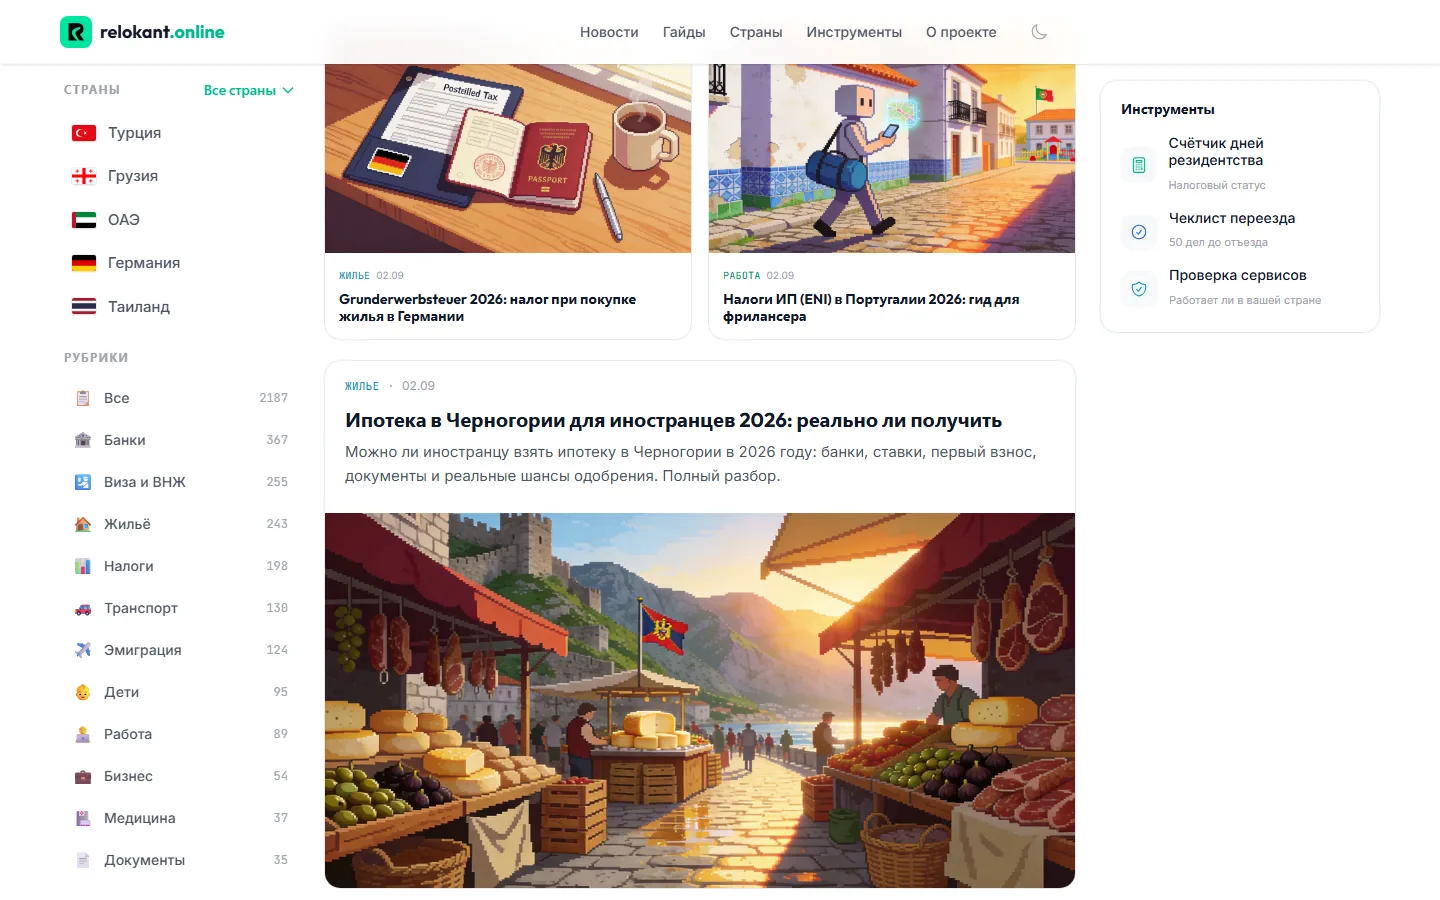
A home mostra a estrutura toda de uma vez: os países na coluna da esquerda, as editorias abaixo deles com a quantidade de materiais de cada uma, as notícias no topo do feed e as ferramentas à direita.
Quem chega da busca em um artigo só consegue sair de lado a partir dele, para o país, para a editoria, para uma ferramenta, sem voltar para os resultados de busca. É isso que impede um site grande de virar uma pilha de páginas soltas.
Um site de mídia com centenas de páginas
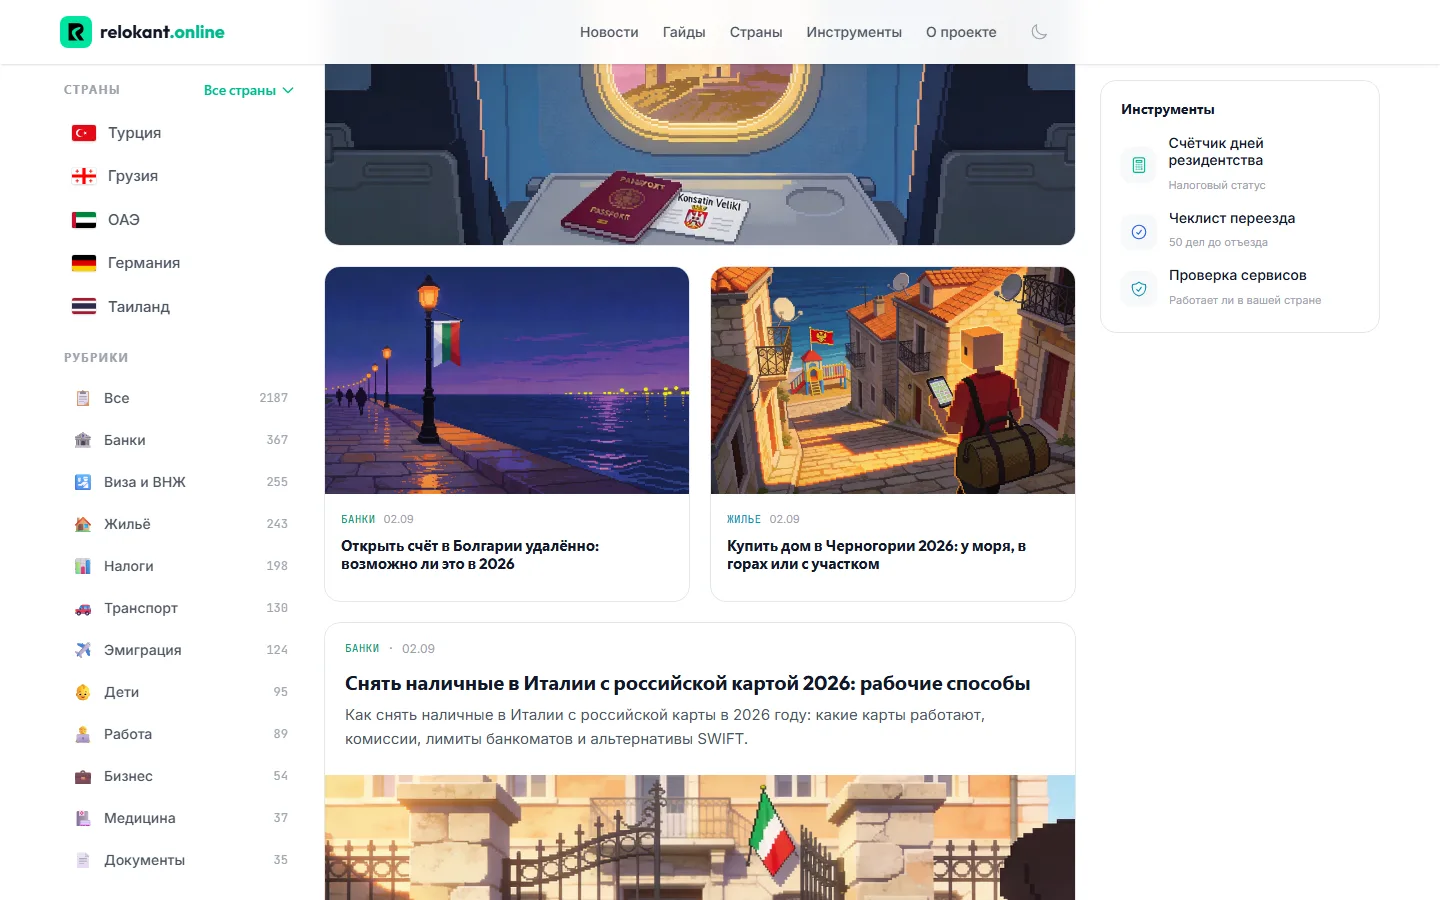
O feed mistura notícias e guias. Cada card traz a editoria, a data e uma linha sobre o que tem dentro, e todos os artigos são ilustrados no mesmo estilo, então um feed longo continua se lendo como uma publicação só.
O layout foi feito para que mais cem páginas não mudem nada na estrutura: um artigo novo escolhe o seu país e a sua editoria e cai onde os leitores já procuram por ele.
O mapa de palavras-chave sob o plano editorial
Antes dos textos veio o mapa: quais buscas existem em volta de cada país e de cada editoria, quais delas merecem uma página própria e quais cabem dentro de um artigo que já existe. O plano editorial sai desse mapa, e não o contrário.
Os temas com mais procura carregam mais material: bancos, vistos e autorizações de residência, moradia, impostos. Isso aparece nos contadores ao lado de cada seção.
Escrito para a busca e para as respostas de IA
As páginas são escritas para que uma máquina consiga citá-las: a resposta fica perto do começo, os títulos dizem sem rodeios o que vem embaixo deles, e os fatos são apresentados como fatos, não como introdução. É disso que um assistente precisa quando monta uma resposta e indica a fonte.
As ferramentas fazem parte do mesmo plano. Um contador de dias de residência, um checklist de mudança e um verificador de serviços respondem a buscas próprias e dão ao portal páginas que não são artigos.
Por dentro do projeto
O portal é abastecido por um sistema que roda em um servidor próprio. Abaixo está o que ele acompanha, como um texto vai do sinal até a página publicada e o que o site mostra aos buscadores.
Fluxo editorial
O que o sistema acompanha a cada hora
A cada hora o servidor passa por 49 sites de governo em 34 países, 32 feeds de notícias e 22 pares de moedas do banco central.
Três trilhas para três tipos de sinal
Um modelo lê cada sinal e o encaminha por uma de três rotas: uma nota curta de 50 a 100 palavras, uma notícia de 300 a 600 ou um guia longo que uma pessoa revisa antes de publicar.
Nove passos do sinal até a página
Cada artigo passa pela mesma cadeia: checagem de duplicidade, roteiro, rascunho, edição, checagem de fatos, formatação, ilustração própria, relatório de revisão e só então a publicação.
Travas antes de o site ir ao ar
Três scripts conferem a build antes do deploy: a própria build, o formato dos artigos e as regras de publicação.
Busca e marcação
Um sitemap de 2.276 endereços
No dia da auditoria o sitemap listava 2.276 endereços; ele é gerado pelo próprio site, não mantido à mão. O sitemap
Regras para os rastreadores de IA
O robots.txt libera a entrada dos rastreadores dos modelos de linguagem — GPTBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended e outros — e barra dois que levam o texto sem devolver leitores. llms.txt
Marcação de artigos e notícias
Os artigos levam dados estruturados em JSON-LD dos tipos Article, NewsArticle, FAQPage e HowTo, e a home declara o site e a publicação.
Entrega e privacidade
O feed para leitores e agregadores
O portal publica um feed RSS, então agregadores e aplicativos de leitura pegam o material novo sem ninguém entrar no site. O feed RSS
Imagens e entrega das páginas
As imagens são servidas por um domínio próprio, quase todas em webp, e todas menos as duas primeiras carregam conforme a rolagem.
A página de privacidade e os contadores
A política de privacidade está publicada e linkada no rodapé. Política de privacidade
No celular
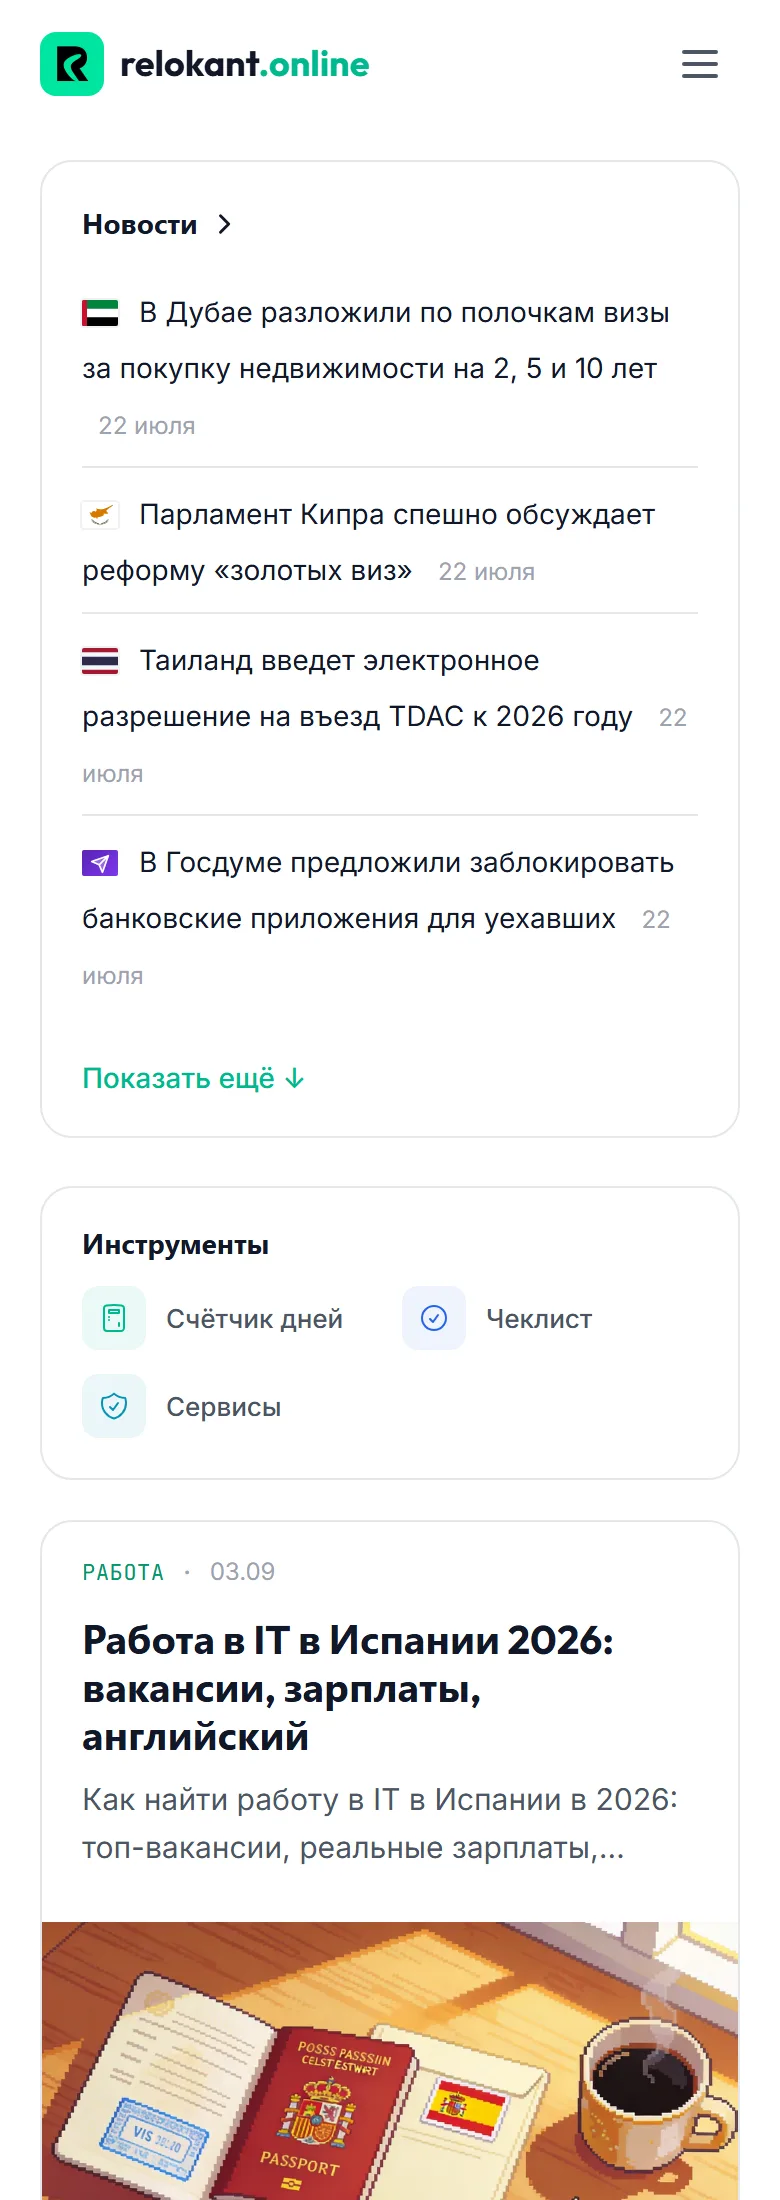
O que saiu disso
- Centenas de páginas de conteúdo e tráfego constante de busca
- Países, editorias, notícias e ferramentas em uma estrutura só
- Páginas escritas de um jeito que as respostas de IA conseguem citar
O portal roda na própria estrutura. Um artigo novo escolhe um país e uma editoria, entra no feed e nas seções e começa a juntar tráfego de busca sem que nada precise ser remontado. Publicar virou trabalho de redação, não de desenvolvimento.